// 成果
- 个本地模型 AI 智能体
- 34
- 个财务计算器
- 11
- 显存运行全套本地模型
- 28.8 GB
// 运行实况
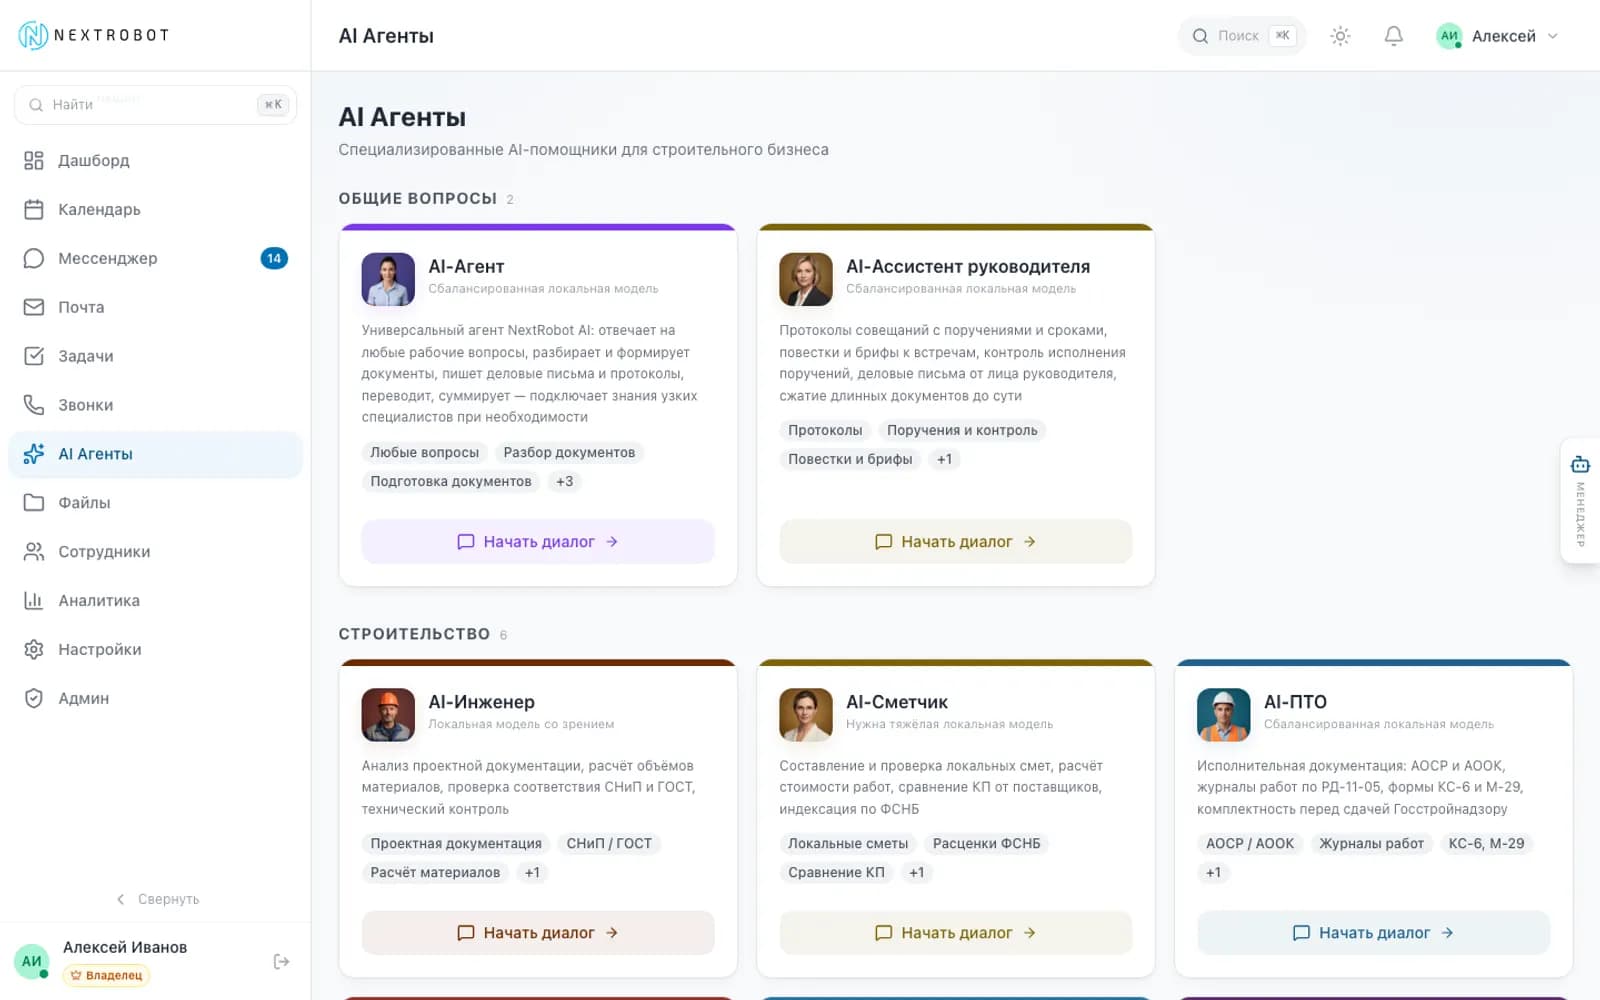
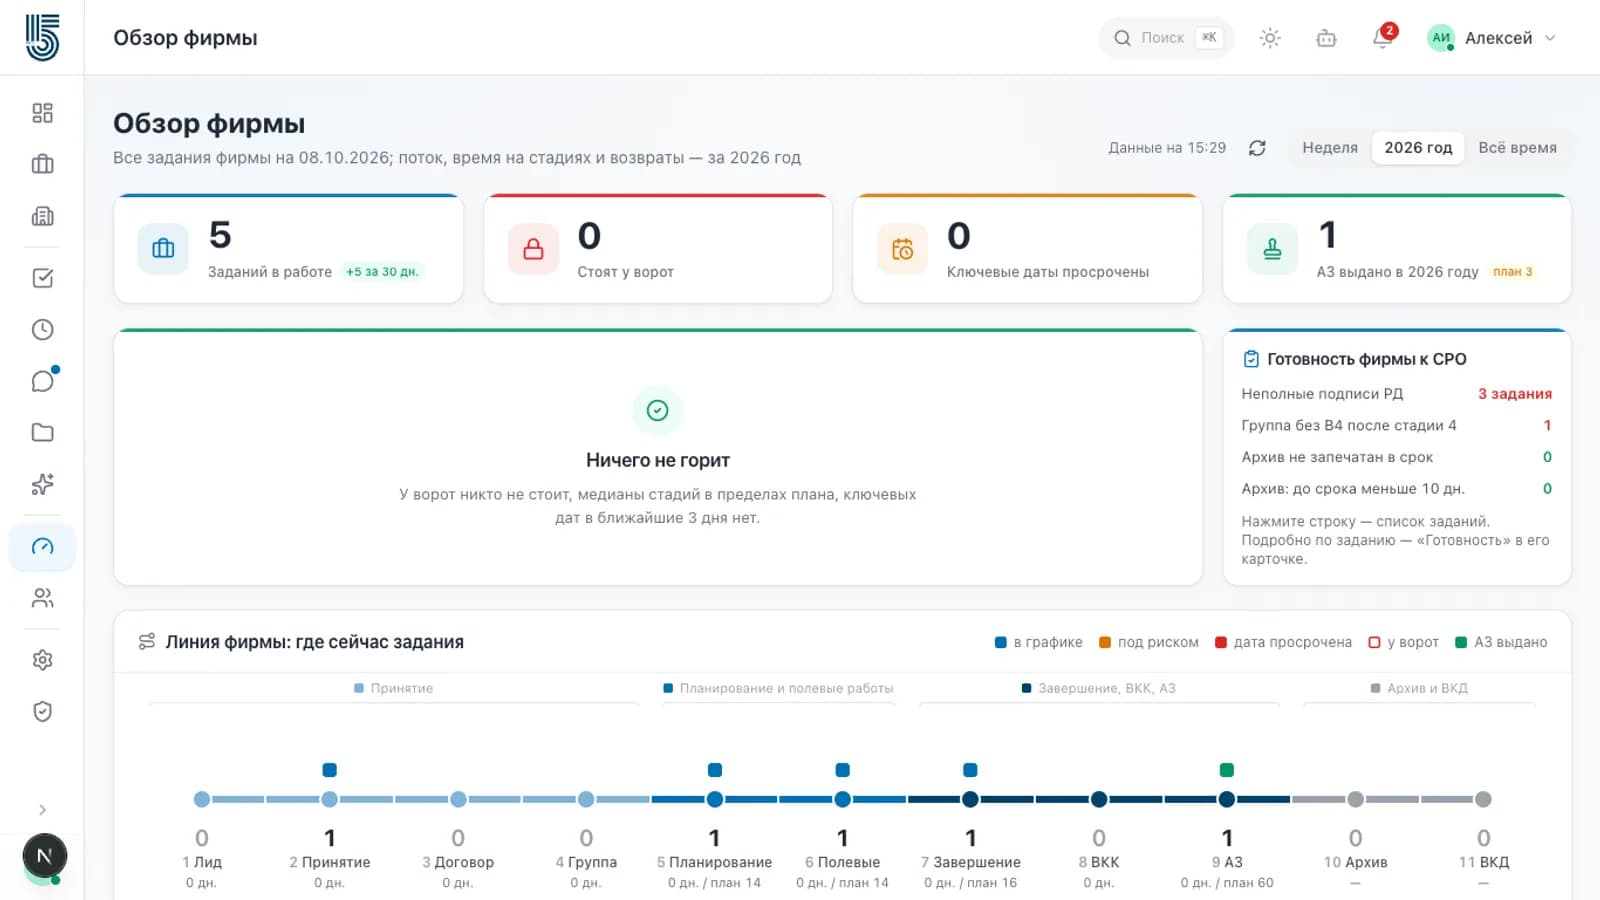
一个企业工作空间中的34个AI智能体 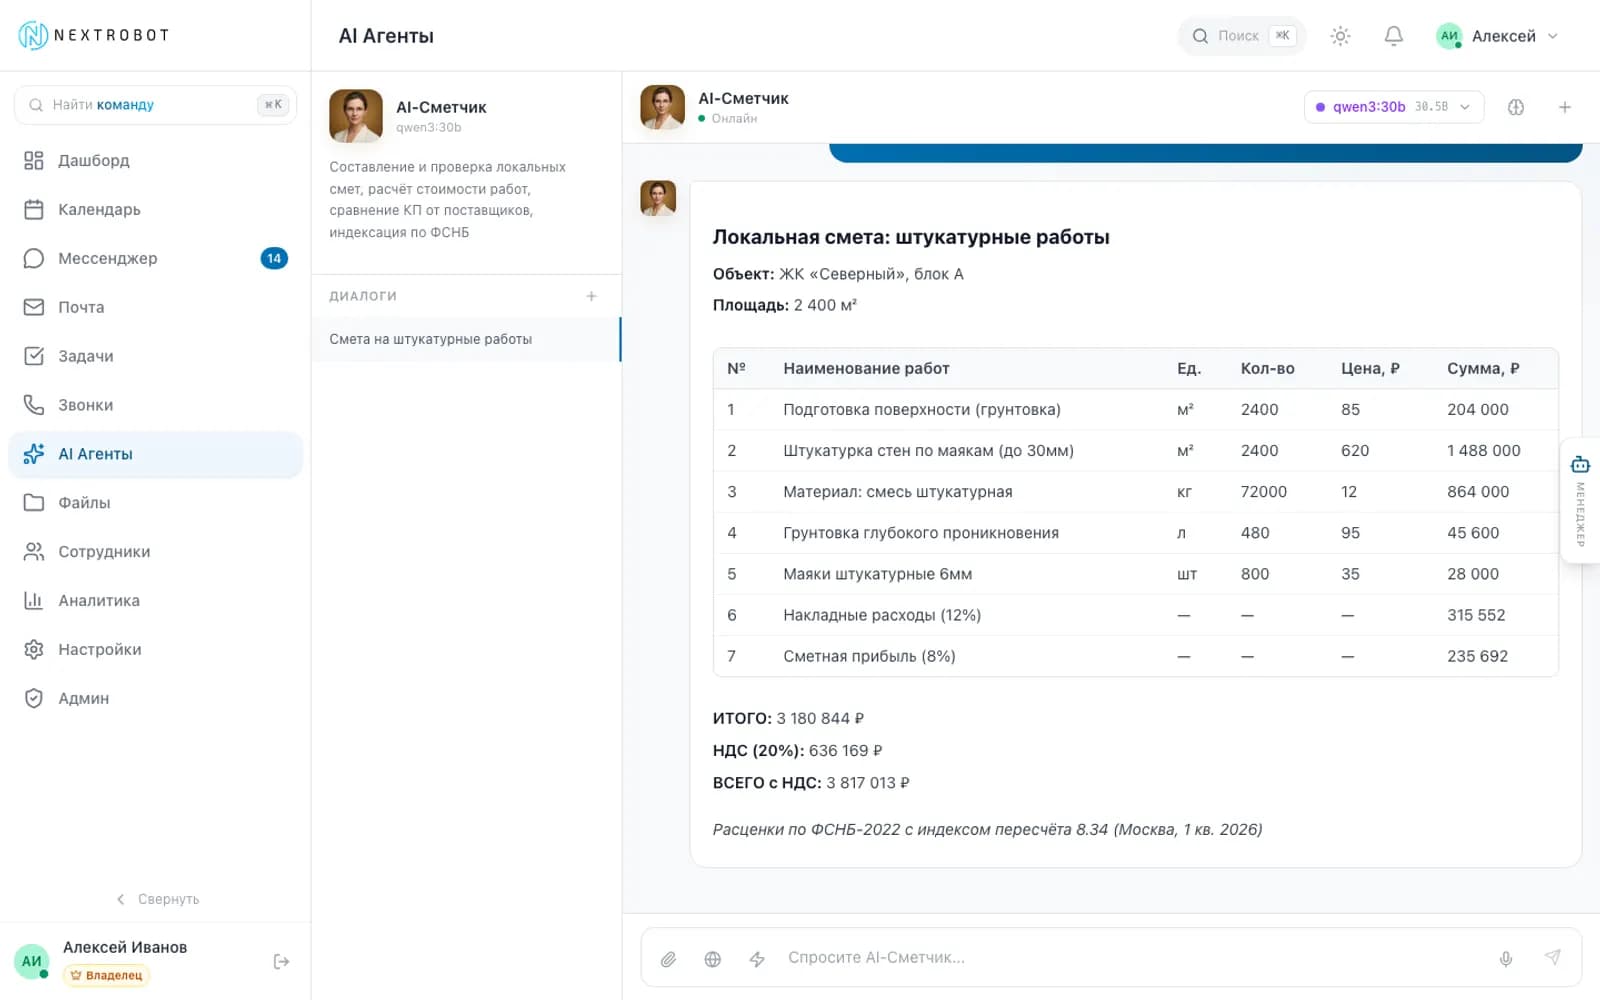
AI造价师生成带单价的预算 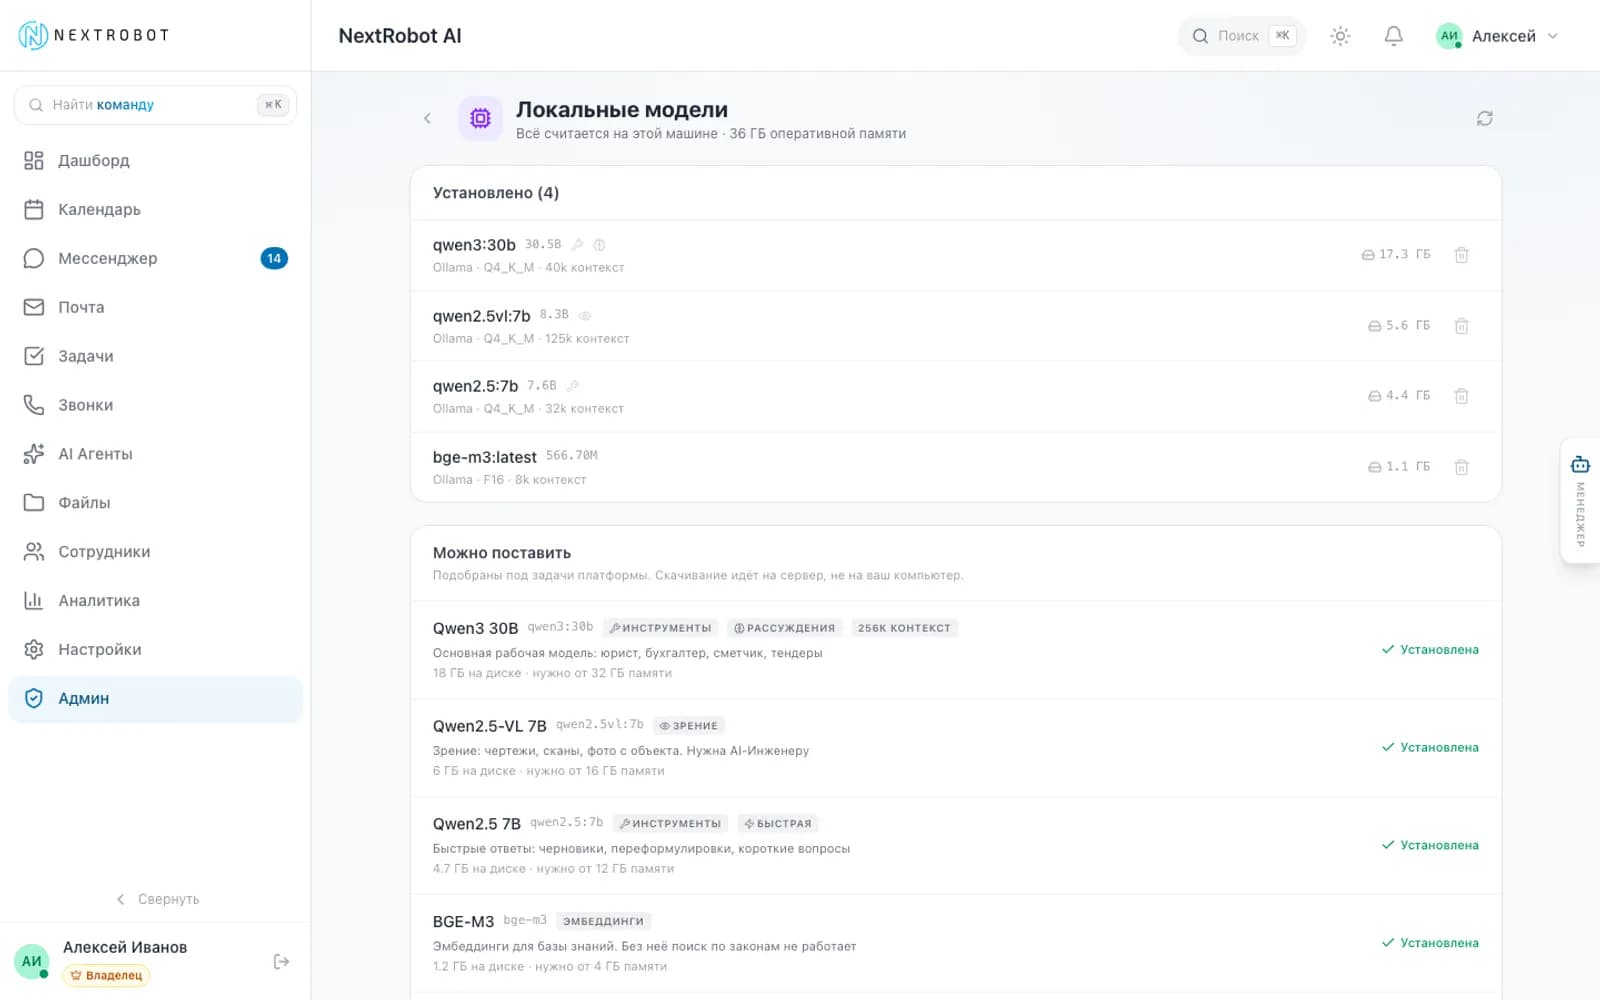
本地模型运行在您自己的服务器上 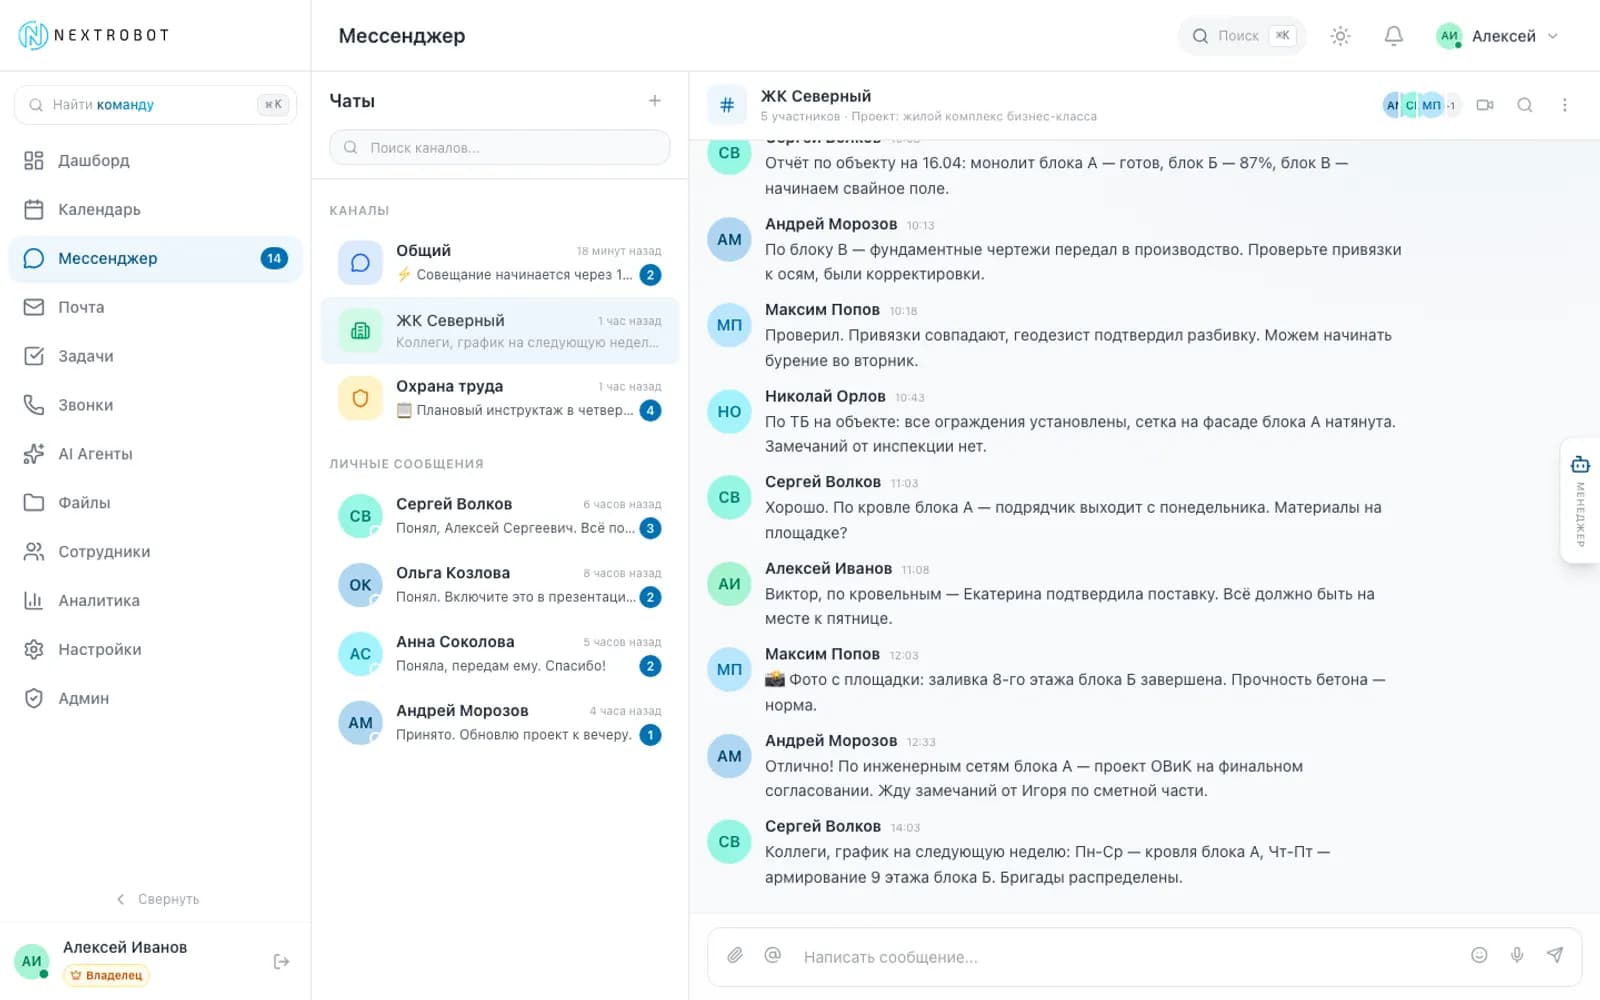
面向项目团队的内置通讯
我们打造了什么
NextRobot Work 通过 Ollama、vLLM 或 llama.cpp 运行 Qwen 级模型和 BGE-M3 向量模型,结合企业文档混合 RAG 和本地联网搜索。经理智能体把一个请求拆成最多 8 个子任务,分配给智能体和员工。
- 34 个智能体:法务、财务、采购、HR、工程
- 负责多步骤请求的经理智能体
- 带法律语料库的混合 RAG
- whisper.cpp 本地通话转写
// 技术栈
- Next.js
- 本地大模型(Qwen、vLLM、Ollama)
- 混合 RAG
- whisper.cpp
- LiveKit
- Capacitor
// 下一个案例
// 您的项目
为您打造同款系统
描述您的任务,工程师 24 小时内回复方案与报价。
- 免费 AI 评估
- 固定价格试点
- 可签保密协议