// 交付内容
一个成果,四个组成部分
- 01
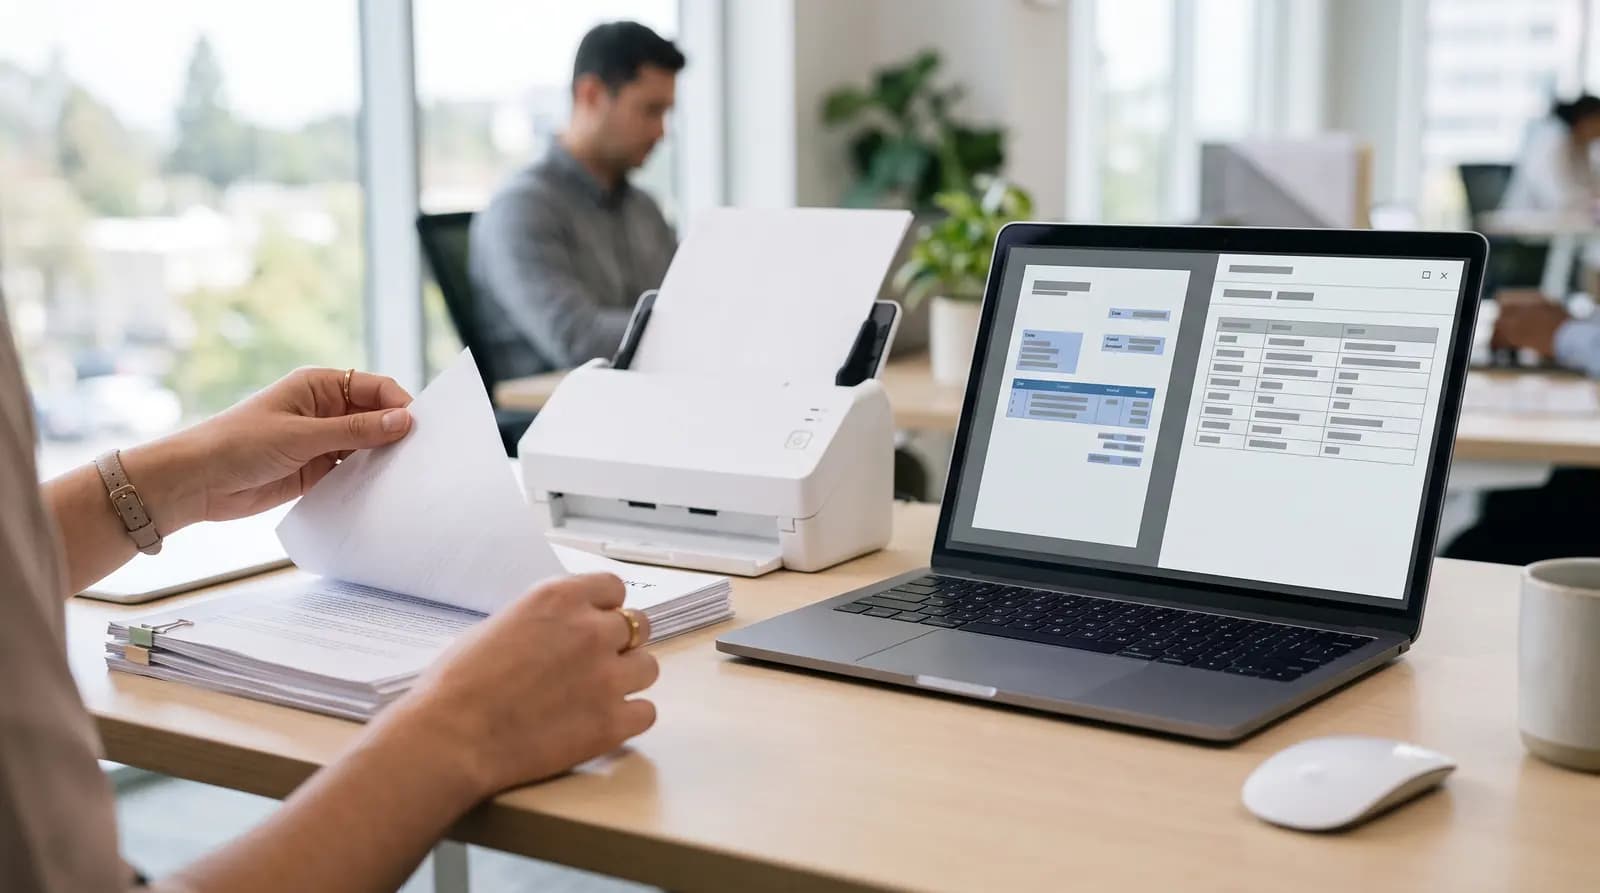
OCR 与解析
识别扫描件、PDF 和照片,完整保留表格与结构。
- 02
信息抽取
当事方、金额、期限和明细导出为 JSON、Excel 或 ERP。
- 03
溯源检索
答案基于原文,并链接到具体页面。
- 04
核查
需求清单、合同比对与差异报告。
// 成效
试点目标
- 手工录入减少(常规目标)
- 60–80%
- 答案附原文引用
- 100%
- 周完成可运行试点(常规)
- 4–8
所列区间为常规试点目标;您的实际数据在试点期间测量。行业数据均注明来源。
// 常见问题
简明解答
能识别扫描件和照片吗?
可以。我们先用您的样本测试准确率,低置信度字段交由人工复核。
如何保证答案准确?
答案只依据检索到的片段生成,每条结论都链接到出处。
文档可以留在内网吗?
可以。OCR、检索和语言模型都能运行在私有服务器上。
// 如何启动
- #01
样本
约定字段、文档类型和准确率目标。
- #02
流水线
在您的文件上测试 OCR、抽取与检索。
- #03
上线
对接您的系统,持续监控准确率。